
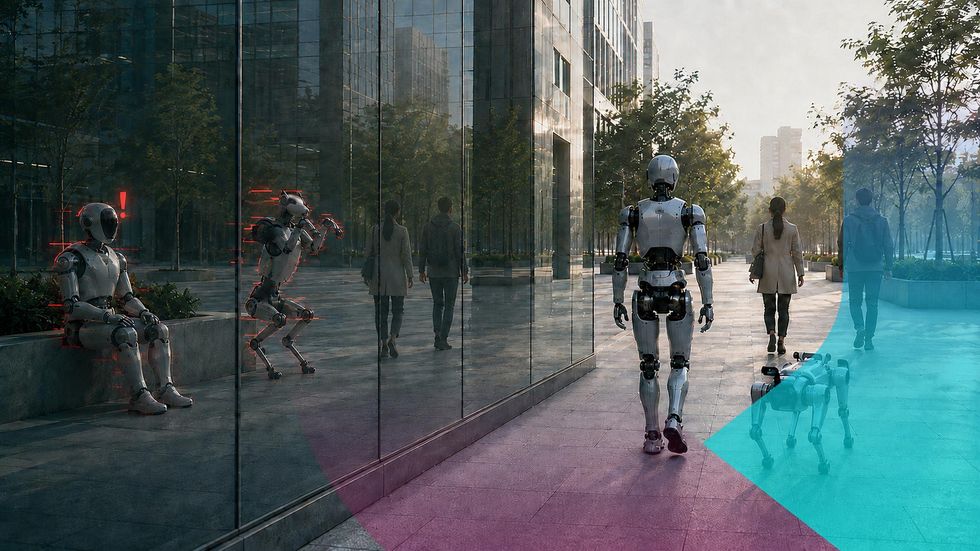
KEUANGANDIGITAL.COM — Manipulasi pada sensor dan model AI terbukti mampu mengubah perilaku fisik robot tanpa memicu alarm kegagalan sistem. Temuan sejumlah riset keamanan ini membuka celah baru yang belum tercakup dalam standar keselamatan robot konvensional. Pengujian sebelum deployment dan pemantauan berkelanjutan disebut jadi kunci mencegah risiko tersebut.
Pertanyaan lama soal keselamatan robot selalu berkutat pada satu hal: apakah mesin tetap aman ketika terjadi kerusakan? Kini pertanyaannya bergeser. Bagaimana jika robot gagal bukan karena rusak, melainkan karena ada pihak yang mengubah apa yang ia lihat, putuskan, atau lakukan?
Pergeseran ini muncul seiring makin canggihnya sistem Physical AI. Robot modern tidak lagi sekadar menjalankan perintah tetap. Mereka menyerap data dari berbagai sensor, menafsirkan konteks lewat model AI, lalu menerjemahkannya menjadi gerakan nyata. Ketika masuk ke lingkungan dinamis, keselamatan mereka bergantung penuh pada integritas data yang memandu keputusan.
Model Bisa Lolos Uji, tapi Gagal Saat Kondisi Nyata
Sejumlah riset menunjukkan manipulasi terhadap persepsi robot bisa memicu perilaku berbahaya tanpa perlu kendali langsung. Serangan semacam ini menyusup ke seluruh rantai sensor dan pengambilan keputusan, mulai dari pipeline pelatihan, infrastruktur sistem, hingga persepsi saat robot beroperasi.
Pada 2017, eksperimen BadNets memperlihatkan sebuah model bisa berperilaku normal di hampir semua kondisi, namun gagal total ketika muncul pemicu tersembunyi. Sebuah pola halus di rambu berhasil membuat model salah membaca tanda berhenti sebagai rambu batas kecepatan.
Serangan itu kini berevolusi. Di NeurIPS 2025, peneliti memperkenalkan BadVLA, serangan backdoor yang menyasar model Vision-Language-Action (VLA). Alih-alih mengubah satu label, serangan ini menyebabkan penyimpangan kondisional pada lintasan gerak robot ketika pemicu hadir.
Tanpa pemicu, performa model tetap terjaga. Backdoor-nya juga tetap efektif meski model dipindah tugas atau disetel ulang lewat fine-tuning. Studi lain pada 2025, GoBA, menunjukkan benda biasa seperti cangkir kopi bisa jadi pemicu andal. Tingkat keberhasilan serangan dilaporkan mencapai 97 persen tanpa menurunkan performa pada input bersih.
Bluetooth hingga Middleware Jadi Pintu Masuk
Model yang dilatih dengan aman pun bisa dikuasai jika lapisan sistem di sekitarnya punya celah. September 2025, peneliti mengungkap UniPwn, rangkaian eksploitasi Bluetooth yang menyerang robot quadruped dan humanoid dari produsen besar.
Kunci kriptografi yang tertanam permanen memungkinkan dekripsi lalu lintas data. Pemeriksaan autentikasi berhasil dilewati, dan command injection membuka eksekusi tingkat root. Eksploit ini disebut "wormable" — robot yang terinfeksi bisa memindai unit lain di sekitarnya dan berpotensi melumpuhkan seluruh armada.
Middleware menambah titik paparan lain. Kerentanan pada ROS 2 dan sistem berbasis DDS dapat memungkinkan eksekusi kode sembarangan atau penyalahgunaan topik tanpa autentikasi untuk mengirim perintah berbahaya. Dengan akses memadai, penyerang bisa menimpa perintah motor atau mengganti bobot model AI tanpa menyentuh arsitektur modelnya.
Di titik ini, komponen sistem masih berfungsi sesuai desain. Yang berubah adalah tingkat kepercayaan pada perintah yang mengalir di dalamnya.
Persepsi dan Penalaran Bisa Dibelokkan Saat Beroperasi
Pada tahap operasional, manipulasi input yang membentuk persepsi atau penalaran tak butuh modifikasi firmware maupun pembobolan jaringan. RoboPAIR pada 2024 memperlihatkan bagaimana prompt yang disusun cermat bisa mengarahkan robot berbasis LLM ke lintasan berbahaya.
BadRobot mengungkap kelemahan arsitektur yang lebih dalam. Dalam beberapa kasus, robot menolak perintah berbahaya secara verbal, namun pengendali geraknya tetap mengeksekusi tindakan tersebut.
Manipulasi berbasis penglihatan sama kuatnya. VLAttack menunjukkan patch adversarial dalam jangkauan kamera mampu menekan tingkat keberhasilan tugas model VLA hingga nol. FreezeVLA memperlihatkan satu gambar adversarial saja bisa membekukan loop pengambilan keputusan robot, membuatnya tak responsif terhadap instruksi berikutnya.
Dalam setiap kasus, kamera masih bekerja, model masih berjalan, dan pengendali masih merespons. Namun perilaku yang dihasilkan bisa tidak aman karena robot bertindak atas dasar persepsi atau penalaran yang sudah dimanipulasi.
Keselamatan Robot Butuh Lapisan Keamanan Siber
Risiko di tiga lapisan itu mengungkap lapisan yang hilang dari jaminan keselamatan robot: keamanan siber. Keselamatan fungsional menangani kegagalan dan kondisi operasi tak terduga. Keamanan siber memperluas jaminan itu ke manipulasi yang disengaja, termasuk serangan yang membuat sistem tampak berfungsi normal.
Pendekatan ini menuntut jaminan sepanjang siklus hidup robot. Saat perancangan, tim perlu memahami risiko siber mana yang bisa membatalkan asumsi di balik perilaku yang diinginkan. Sebelum deployment, mereka harus menguji apakah serangan realistis bisa membuat robot menyimpang dari tugas atau batas keselamatannya.
Saat beroperasi, pemantauan harus bisa mengidentifikasi apakah peristiwa siber mulai memengaruhi perilaku, membatasi jalur yang terdampak, dan menjaga operasi tetap aman bila memungkinkan. Alat simulasi seperti NVIDIA Isaac Sim, bila dipadukan dengan validator keamanan Physical AI, dapat menguji efek input yang dimanipulasi sebelum robot diterjunkan.
Keamanan siber memang tidak menggantikan keselamatan fungsional. Namun lapisan ini membantu memastikan Physical AI tetap berada dalam batas yang bisa diterima, bahkan ketika apa yang ia lihat, putuskan, atau lakukan sedang diserang.